给技术文档做一套能溯源的问答系统
摘要
针对技术文档查阅依赖人工翻阅与关键词搜索的问题,本文设计了一套可对话、可溯源的问答系统。系统由文档接入、混合检索、上下文组装与生成、权限管理、评测运营五个模块组成。本文讨论其中四处关键设计:可溯源所需的三个必要条件、混合检索中 BM25 的必要性、结构感知切分为主固定长度兜底的依据,以及参数寻优对评测集的隐含依赖。
1 引言
日常查阅技术文档的体验大致有两种:逐级点开目录人工翻阅,或全文搜索关键词后于大量结果中筛选。
本系统要改变这一点。在可对话、可溯源、可度量三个目标之中,我最看重的是可溯源——一个回答正确却无法给出依据的系统,在技术场景中不具备可用性。工程师需要点开原始段落,自行判断结论是否成立。
这也延续了此前数篇的同一思路:从”直接询问模型”到”令模型仅依据自有文档作答”,其间的差距不在模型能力,而在检索与约束。
2 系统总体设计
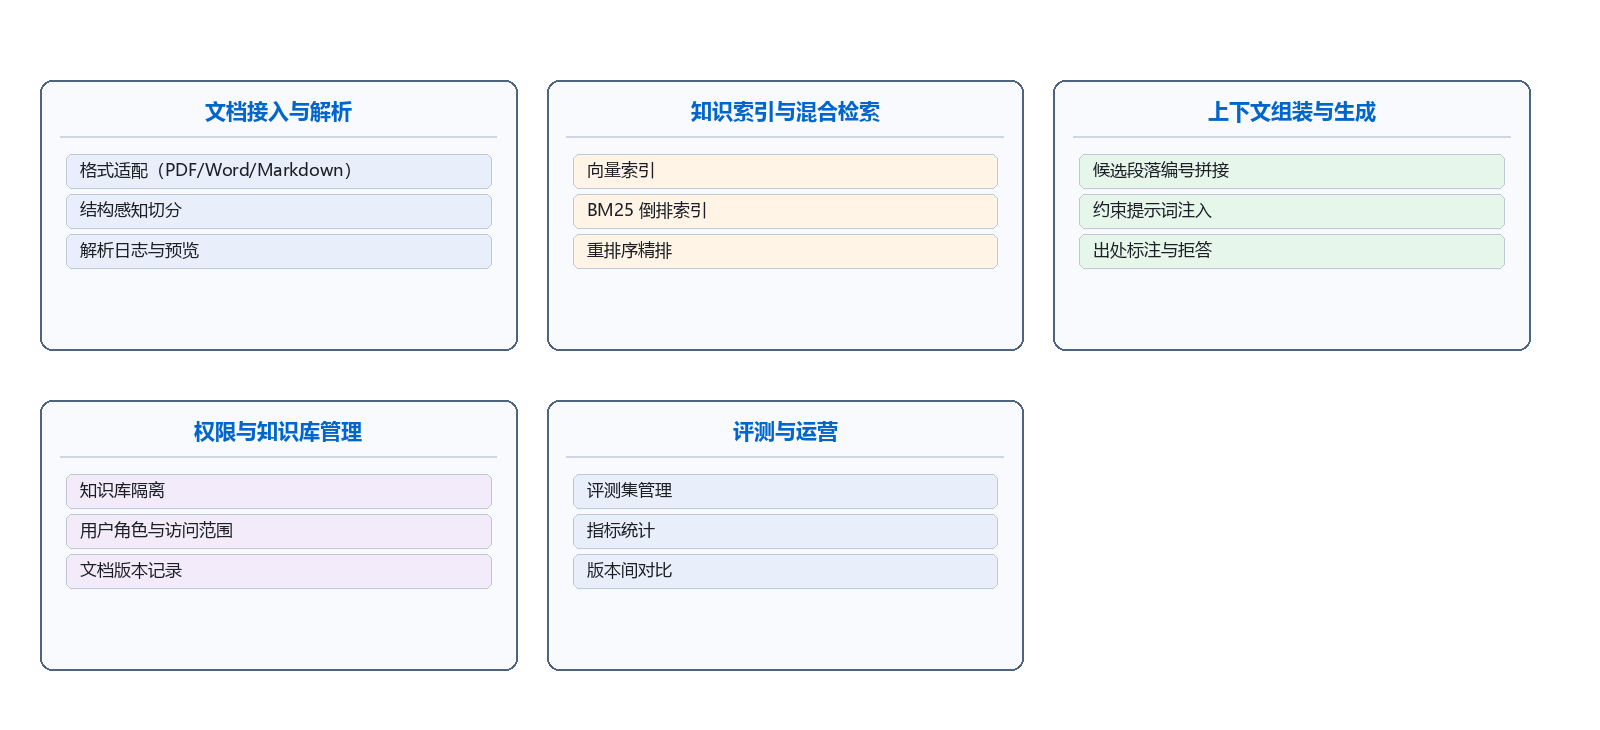
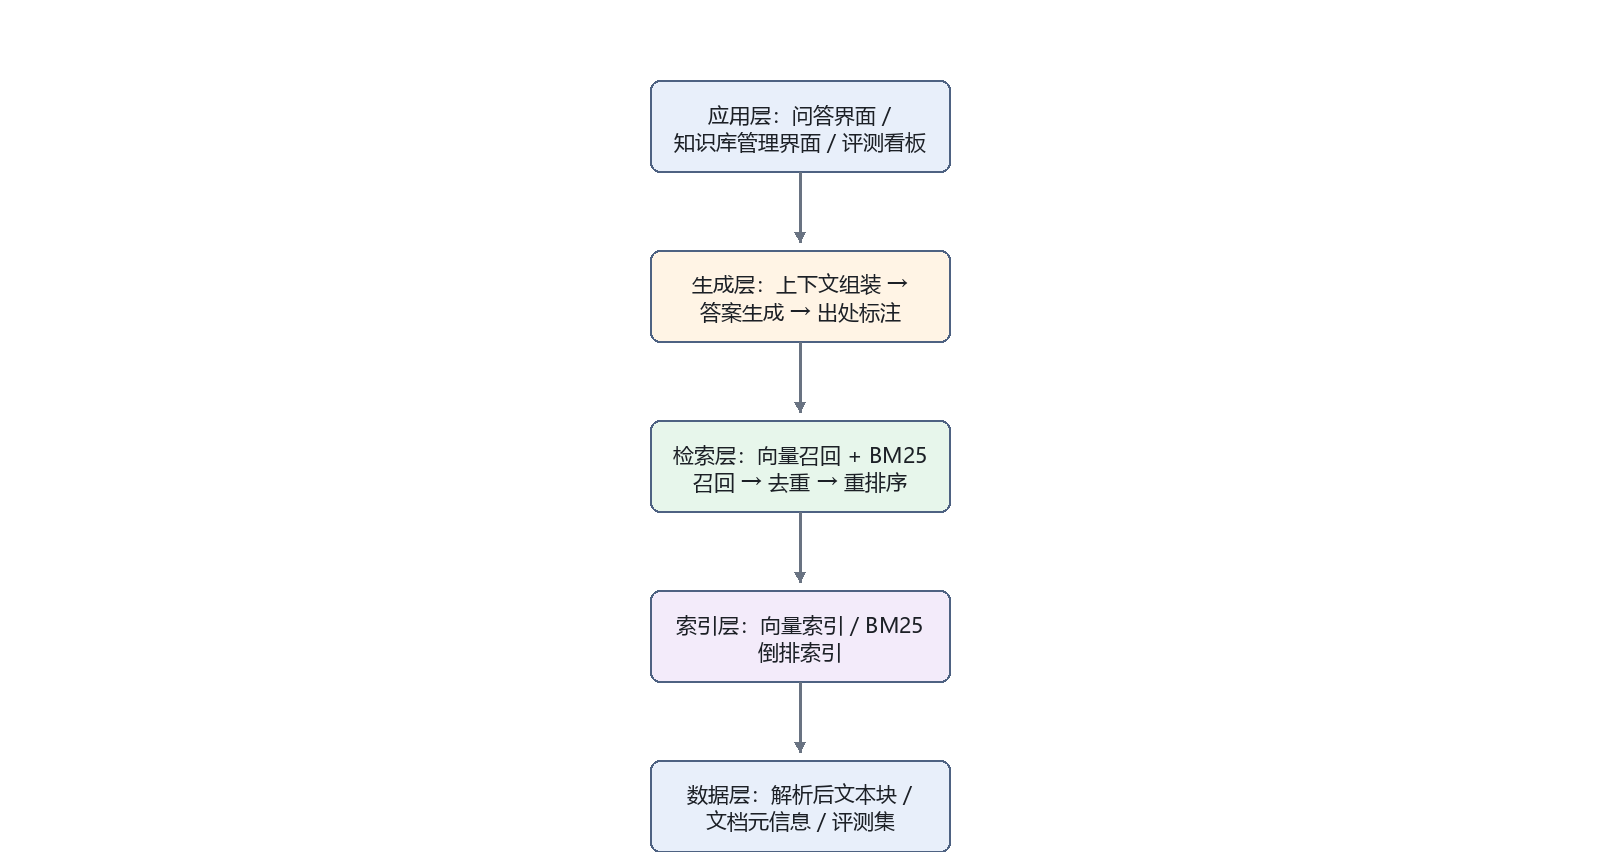
系统由五个模块构成:文档接入与解析、知识索引与混合检索、上下文组装与生成、权限与知识库管理、评测与运营。各模块职责与完整设计参数见附录,下文只讨论关键设计取舍。
3 关键设计取舍
3.1 混合检索:为什么必须包含 BM25
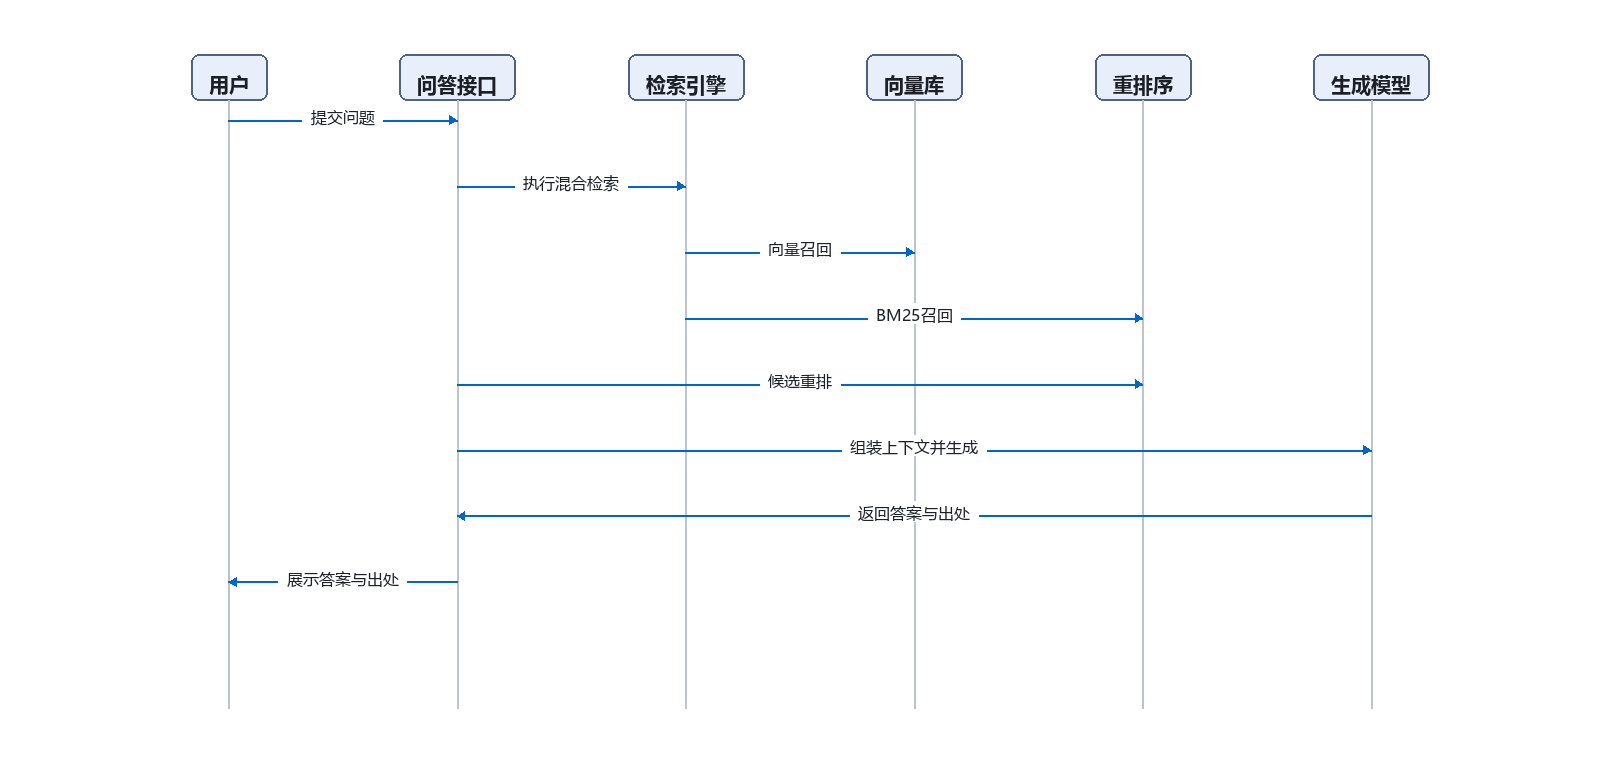
检索采用向量召回与 BM25 倒排召回并存的三级结构:向量负责语义相似匹配,BM25 负责精确标识符命中,重排序对去重后的候选集精排。
保留 BM25 的理由很直接:在技术文档中,查询一个精确标识符——函数名、错误码、参数名——是高频需求,而向量检索对此类查询的稳定性反而较差。两种召回互补,这是混合检索存在的根据,而非为了堆叠技术。
3.2 可溯源由三个条件共同保证
将候选段落与编号一并注入上下文,并配以约束提示词,要求模型对每个论断挂接来源编号,输出答案与出处列表两部分;同时在候选段落与问题相关度低于阈值时直接拒答,不作无依据回答。
三个条件合起来才构成完整的可溯源:给料编号、要求挂编号、没有料就拒答。缺少任何一项,输出都会退化为一篇没有依据的流畅文本。
3.3 结构感知切分为主,固定长度兜底
切分策略需在固定长度、结构感知与语义切分之间取舍。最终以结构感知为主、固定长度兜底,理由是技术文档的标题层级本就是现成的结构信息,无需额外计算即可利用;固定长度切分易在句子中间截断,破坏语义单元;语义切分效果最好,但需逐段计算相似度,开销过高。
此外,切分结果提供预览与人工修正。自动切分必然存在错误,允许人工修改比重新上传更为经济。
3.4 混合权重的扫描结果有其前提
融合得分由向量与稀疏两项加权得到,权重在评测集上按步长扫描,取检索层命中率最高处。
这一做法存在一个必须说明的隐含前提:扫描所得的最优权重仅对当前评测集成立。更换文档集合或提问风格后,最优值可能发生偏移。因此评测集须设计为可替换,而非将单一数值固化于系统之中。
4 评测:没有评测集,优化就只是凭感觉
评测集覆盖三类样本:可直接定位的、需跨段落综合的、知识库无内容的。指标分检索层与生成层两层,前者考察答案段落是否被召回,后者考察论断是否被候选段落支撑、来源编号是否指向正确。
建库流程的最后一步是导入评测集并记录指标基线。我认为这是整套系统中投入最多、也最不可跳过的一层——没有评测基线,所谓优化只能停留在凭感觉调整参数。
5 尚未实测的部分
有一点须如实说明:本设计目前给出的是方法与指标口径,尚未跑出实测数字。设计文档中最容易自欺的表述正是”预期提升明显”一类。此处记录的真实状态是:尚不清楚提升幅度,但已明确应如何度量它。
此外,权限与知识库隔离部分面向多部门场景设计,其在真实组织中的落地方式有待验证。
6 结论
本文的工作表明,此类系统的关键不在模型选型,而在检索的完备性与约束的严格性:BM25 保证精确标识符可查,三个条件共同保证答案可溯源,评测基线保证优化可度量。三者缺一,系统便从”知识服务”退化为”流畅的文本生成”。
附件